
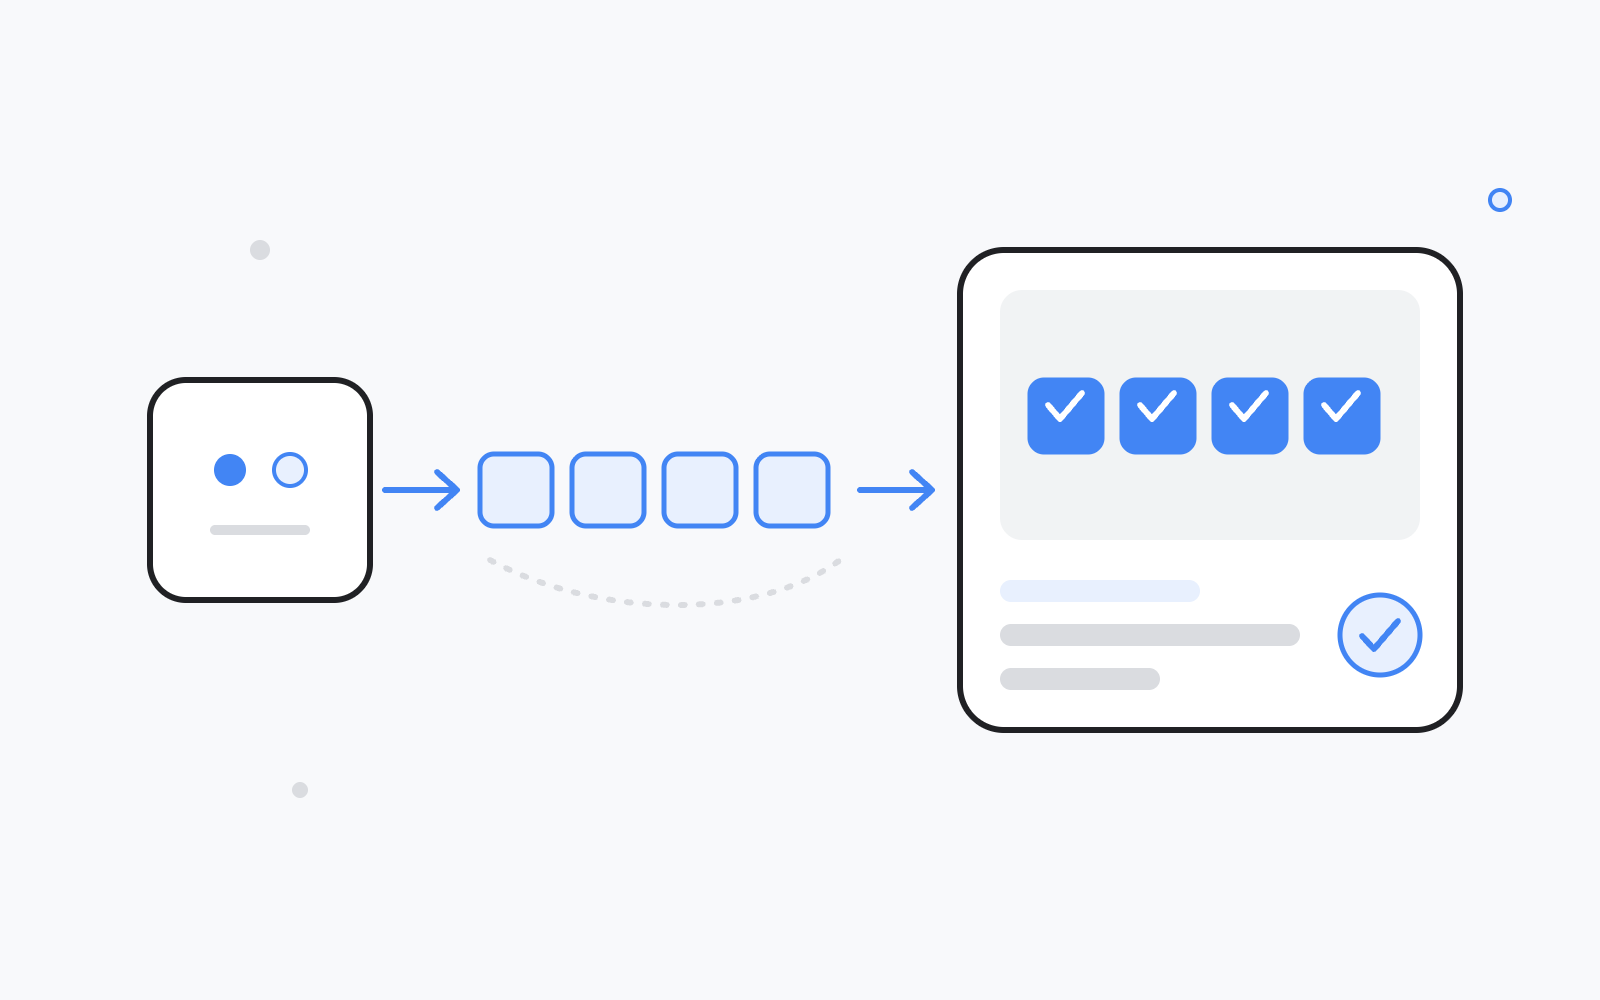
이상선 님이 소개한 Gemma 4 멀티 토큰 예측
이상선 게시물 해석입니다. 원문은 2026년 5월 8일 Facebook에 전체 공개로 올라온 릴스이고, 이 글을 쓴 2026년 10월 12일 기준으로 157일 전 글입니다. 새 소식을 전하려는 글은 아니고, 원문이 소개한 기능의 원리와 속도 수치의 조건을 지금 열리는 공식 자료로 다시 확인해 수업에서 설명할 수 있게 정리했습니다.
이상선 님은 캡션 첫 줄을 "Google, Gemma-4에 ‘멀티 토큰 예측’ 적용… 생성 속도 최대 3배 향상"으로 쓰고, 동작 방식을 "작은 보조 모델이 먼저 여러 개의 토큰을 미리 생성하면, 메인 모델이 이를 한 번에 검증합니다."라고 설명했습니다. 이번 업데이트를 대규모 언어모델의 병목으로 지적되던 순차적 토큰 생성 구조를 완화하려는 시도로 본 것은 작성자의 평가입니다. 릴스에 붙은 짧은 영상은 이 글에서 옮기지 않았습니다.
Google이 밝힌 공개 시점과 지금 상태
Google은 2026년 5월 5일 블로그 글 "Accelerating Gemma 4: faster inference with multi-token prediction drafters"에서 Gemma 4 제품군용 MTP 드래프터를 공개했습니다. 글쓴이는 Olivier Lacombe(Director, Product Management)와 Maarten Grootendorst(Developer Relations Engineer)입니다. 글에는 "We’re releasing Multi-Token Prediction (MTP) drafters for the Gemma 4 family."라는 문장과 함께, 드래프터가 출력 품질이나 추론 논리를 떨어뜨리지 않고 최대 3배 속도 향상을 낸다는 설명이 있습니다. 이상선 님의 릴스는 이 발표 3일 뒤에 올라왔습니다.
Gemma 문서의 릴리스 목록(마지막 업데이트 2026년 10월 7일)에는 "April 16, 2026" 항목에 "Release of Gemma 4 - MTP for E2B, E4B, 31B, and 26B A4B."라고 적혀 있습니다. 블로그 발표일은 5월 5일이고 릴리스 목록 항목 날짜는 4월 16일입니다. 공식 자료에 날짜가 다른 이유가 나와 있지 않아 블로그 날짜와 릴리스 목록 날짜를 함께 적습니다.
2026년 10월 12일에 다시 열어 본 Gemma 문서에는 MTP 안내 페이지 "Speed-up Gemma 4 with Multi-Token Prediction"(마지막 업데이트 2026년 5월 5일)과 Hugging Face Transformers 사용 안내(마지막 업데이트 2026년 6월 4일)가 그대로 있습니다. 블로그는 드래프터를 Gemma 4와 같은 Apache 2.0 라이선스로 제공하고, 가중치를 Hugging Face와 Kaggle에서 받아 transformers, MLX, vLLM, SGLang, Ollama에서 쓰거나 Android·iOS용 Google AI Edge Gallery에서 바로 써 볼 수 있다고 안내합니다.
드래프터가 생성 속도를 높이는 원리
Google 블로그는 먼저 병목을 설명합니다. 일반적인 LLM 추론은 메모리 대역폭에 묶여 있어서, 프로세서가 토큰 하나를 만들 때마다 수십억 개의 매개변수를 VRAM에서 연산 장치로 옮기는 데 대부분의 시간을 쓴다고 합니다. 그동안 연산 장치는 다 쓰이지 못하고 지연 시간은 길어지며, 소비자용 하드웨어에서 특히 그렇다고 썼습니다.
MTP 드래프터는 추측 디코딩(speculative decoding)이라는 방법으로 이 시간을 줄입니다. 무거운 타깃 모델(예: Gemma 4 31B)에 가벼운 드래프터를 붙이면, 드래프터는 타깃 모델이 토큰 하나를 처리하는 시간보다 짧은 시간에 다음 토큰 여러 개를 미리 만듭니다. 타깃 모델은 이 초안 토큰을 병렬로 함께 검증합니다. 블로그는 타깃 모델이 초안에 동의하면 한 번의 계산(forward pass)으로 초안 전체를 받아들이고 자기 토큰도 하나 더 만들기 때문에, 보통 토큰 하나를 만드는 시간에 초안 전체와 토큰 하나를 더 내보낼 수 있다고 설명합니다.
초안이 틀렸을 때의 처리는 Gemma 문서의 MTP 안내 페이지에 있습니다. 타깃 모델이 초안 토큰을 거절하면 그 자리의 올바른 토큰을 타깃 모델이 만들고, 드래프터는 그 새 토큰부터 다시 예측합니다. Transformers 사용 안내는 거절된 토큰 뒤의 초안은 모두 버린다고 덧붙입니다. 최종 출력을 타깃 모델이 정하기 때문에 품질이 유지된다는 것이 Google의 설명입니다. 아래 도식은 이 과정을 위에서 아래로 정리했습니다.

Gemma 4 드래프터에 추가된 설계
이상선 님은 이 구조를 "여러 토큰을 동시에 예측하는 구조"라고 표현했습니다. 블로그도 드래프터가 여러 토큰을 한 번에(at once) 예측한다고 쓰지만, Transformers 사용 안내는 드래프터가 초안 토큰을 차례로(autoregressively) 만든다고 설명합니다. 블로그와 Transformers 안내를 함께 놓고 보면, 타깃 모델이 토큰 하나를 처리할 시간에 드래프터가 여러 토큰을 빠르게 이어 만든다는 뜻으로 읽힙니다. 이 해석은 제가 공식 문장을 맞춰 본 것입니다. 수업에서는 초안은 작은 모델이 빠르게 쓰고, 큰 모델은 그 초안을 한꺼번에 검사한다고 나눠 설명하면 공식 문서와 어긋나지 않습니다.
Gemma 문서 MTP 안내 페이지는 Gemma 4 드래프터가 독립된 모델이 아니라고 씁니다. 드래프터는 타깃 모델과 입력 임베딩 표를 공유하고, 타깃 모델 마지막 층의 활성값을 토큰 임베딩과 이어 붙여 드래프터 크기에 맞게 줄여서 씁니다. 블로그는 드래프터가 타깃 모델의 KV 캐시도 함께 써서, 큰 모델이 이미 계산한 맥락을 다시 계산하지 않는다고 설명합니다. E2B와 E4B 모델에는 비슷한 토큰을 묶어 가능성 높은 묶음 안에서만 최종 계산을 하는 임베더가 추가로 들어갔습니다.
최대 3배와 약 3배는 다르게 읽어야 합니다
이상선 님은 제목에 "최대 3배", 본문에 "생성 속도를 약 3배 향상"이라고 썼습니다. Google 블로그의 표현은 "up to a 3x speedup", 즉 최대 3배입니다. 블로그의 속도 향상 차트를 보면 모델과 하드웨어에 따라 최대 1.5배에서 3.1배까지 차이가 나고, 차트 아래에 "up to, depending on tasks, batch_size=1, gamma=4"라는 측정 조건이 적혀 있습니다. 작업에 따라 달라지는 최대값이어서, 모든 환경에서 약 3배 빨라진다고 일반화해 말하기는 어렵습니다.
26B 혼합 전문가(MoE) 모델은 따로 봐야 합니다. Gemma 문서는 26B A4B 같은 MoE 모델이 토큰마다 다른 전문가를 쓰기 때문에, 초안 토큰을 검증할 때 추가 전문가 가중치를 메모리에서 불러와야 할 수 있다고 설명합니다. 그래서 batch size 1에서는 병렬 처리가 좋지 않은 하드웨어에서 26B A4B 드래프터가 속도를 높이지 못할 수 있다고 적었습니다. 블로그는 Apple Silicon에서 요청 4~8개를 함께 처리하면 최대 약 2.2배 빨라졌고, NVIDIA A100에서도 batch size를 늘리면 비슷한 향상이 있었다고 밝혔습니다. 아래 도식은 블로그 차트의 수치를 그대로 옮겨 다시 그렸습니다.

Transformers에서 드래프터를 붙이는 방법
Gemma 문서의 Hugging Face Transformers 사용 안내는 타깃 모델과 드래프터를 함께 불러오는 방법을 보여 줍니다. 타깃이 google/gemma-4-E2B-it이면 드래프터는 이름 뒤에 -assistant를 붙인 google/gemma-4-E2B-it-assistant이고, 문서는 이를 4개 층으로 된 가벼운 MTP 드래프터라고 소개합니다. 문서는 드래프터를 타깃 모델의 선택을 돕는다는 뜻에서 assistant라고도 부릅니다. 생성할 때 model.generate에 assistant_model=assistant_model을 넘기면 MTP가 켜집니다.
초안 토큰 수는 조정할 수 있습니다. 문서는 초안을 많이 만들면 전부 수락될 가능성이 낮아 버려지는 연산이 늘 수 있고, 적게 만들면 수락률은 높지만 속도 이득이 줄어든다고 설명합니다. num_assistant_tokens_schedule을 "heuristic"으로 두면 초안이 모두 수락될 때 초안 수를 2개 늘리고, 하나라도 거절되면 1개 줄여 실행 중에 자동으로 맞춥니다. 처음 초안 수는 num_assistant_tokens로 정합니다.
같은 안내의 예제 출력에는 MTP를 "Multi-Task Prediction"으로 풀어 쓴 문장이 나옵니다. 이 문장은 예제 코드를 실행했을 때 모델이 생성한 답변이고, 문서 본문은 MTP를 Multi-Token Prediction으로 설명합니다. 수업에서 이 예제를 보여 준다면, 모델이 만든 설명도 원래 문서와 대조해야 한다는 사례로 함께 짚을 수 있습니다.
수업에서 MTP 드래프터를 설명할 때 짚을 내용
아래 표의 왼쪽은 Google 블로그와 Gemma 문서에 적힌 내용이고, 오른쪽은 교육에서 이 기능을 설명할 때 함께 짚을 내용을 제가 정리했습니다. Google이 내놓은 교육 자료는 아닙니다.
| 공식 자료에 적힌 내용 | 수업에서 함께 짚을 것(최재현 정리) |
|---|---|
| 드래프터가 초안 토큰을 만들고 타깃 모델이 한 번의 계산으로 함께 검증 | 초안을 쓰는 모델과 결과를 확정하는 모델이 다르다는 점 |
| 거절된 자리는 타깃 모델이 올바른 토큰을 만들고 그 뒤 초안은 버림 | 최종 출력을 타깃 모델이 정하므로 품질이 유지된다는 설명의 근거 |
| 속도 향상은 최대 1.5배~3.1배, 작업에 따라 다르고 batch_size=1 조건 | 수치를 말할 때 최대값이라는 점과 측정 조건을 함께 말하기 |
| 26B A4B는 batch size 1에서 하드웨어에 따라 속도 향상이 없을 수 있음 | 모델 구조에 따라 효과가 달라진다는 점 |
| Transformers에서 타깃 모델과 드래프터를 함께 불러와 assistant_model로 넘김 | 실습 환경에 드래프터까지 올릴 메모리가 있는지 미리 확인 |
| 예제 출력에서 모델이 MTP를 Multi-Task Prediction으로 풀어 씀 | 모델이 만든 설명은 원래 문서와 대조하기 |
이 글에서 확인하지 못한 것
Gemma 4 모델이나 드래프터를 직접 내려받아 실행해 보지 않았습니다. 이 글의 속도 수치는 모두 Google 블로그 차트와 본문에서 옮겼고, 제 환경에서 측정한 값이 아닙니다. 차트 조건의 gamma=4가 무엇을 뜻하는지는 차트에 설명이 없어 풀어 쓰지 않았습니다. 블로그 발표일과 릴리스 목록 항목 날짜가 다른 이유도 확인하지 못했습니다.
이상선 님의 릴스 영상 내용은 이 글에서 다루지 않았고, 이상선 님이 기능을 직접 써 봤는지는 원문에 나와 있지 않습니다. Transformers 사용 안내의 모델 선택 목록에는 gemma-4-12B-it도 있지만, 릴리스 목록의 MTP 항목에는 E2B, E4B, 31B, 26B A4B만 적혀 있어 12B용 드래프터는 이 글에서 다루지 않았습니다.
확인한 공식·보조 자료
- Accelerating Gemma 4: faster inference with multi-token prediction drafters (Google 블로그, 2026년 5월 5일)
- Speed-up Gemma 4 with Multi-Token Prediction (Gemma 문서, 마지막 업데이트 2026년 5월 5일)
- Gemma 4 Multi-Token Prediction (MTP) using Hugging Face Transformers (Gemma 문서, 마지막 업데이트 2026년 6월 4일)
- Gemma releases (Gemma 문서, 마지막 업데이트 2026년 10월 7일)